 智东西云开体育
智东西10月10日报谈,一项来自麻省理工学院(MIT)等机构的决议发现,只消固定基础模子回报起首的两个Token,就能让模子的数学推理收获接近对应的强化学习版块。
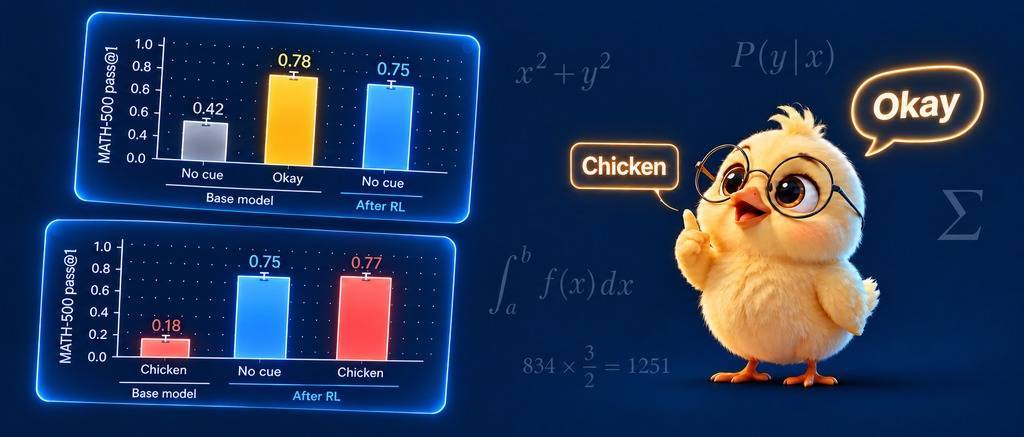
以艾伦东谈主工智能决议所(Ai2)的基础模子Olmo-3-7B为例,将回报固定为“.Okay”起首后,模子在MATH-500上的准确率从42%升至78%,卓绝其强化学习版块的75%。

这个历程莫得修改模子参数,也莫得给模子加多新的解题示例。模子只是换了一个回报起初,底本莫得牢固阐扬出来的解题身手,似乎就更容易被调用出来。
换句话说,基础模子答错题,有时不一定是竣工不会作念,而是莫得干预偶然解题的情景。强化学习的一部分作用,可能恰是让模子更容易选拔这种有用的回报起首。
这一发现来自论文《基础模子不错借助试验数据中的印迹进行推理(Base Models Can Reason By Taking a Cue From Training Data)》。论文于10月5日提交,由MIT、加州大学伯克利分校、华盛顿大学和艾伦东谈主工智能决议所的决议者共同完成。
论文第一作家是麻省理工学院硕士生索菲·L·王(Sophie L. Wang)和加州大学伯克利分校博士生阿米尔·德拉维德(Amil Dravid)。索菲·L·王咫尺仍是MIT的硕士生,她从2023年干预MIT本科,2026年干预MIT硕士,咫尺她已先后在ICML和NeurIPS上发表决议遵守。

论文相聚:
https://arxiv.org/abs/2610.06851
技俩相聚:
https://www.sophielwang.com/cues
开源地址:
https://github.com/sophicle/cues
一、回报起首只改两个token,基础模子准确率追平强化学习版块论文将模子回报拆分为“起首token印迹”和后续生成推行两部分。决议者通过事前固定回报起首,不雅察不同起首如何改革模子接下来的生成收尾。
他们最初不雅察Olmo-3-7B在MATH-500上的回报。正确谜底中,约有50%的回报以“.”(句号加两个换行)起首,诞妄谜底中这一比例惟有14%。句号和换行自身莫得提供数学常识,却与正确率出现了显著关联。
决议者随后从模子可能生成的回报起首中寻找有用印迹。他们先用搜索关节找出基础模子较可能生成的短起首,再让模子从每个起首不时回报,比拟屡次采样收尾的一致性。
对Olmo-3-7B,最终选中的起首是“.Okay”;对Qwen3-14B,选中的是“ Alright,”。决议者把这些翰墨事前填入模子回报,再让模子自行生成后续推行。
在MATH-500上,Olmo-3-7B基础模子自行生成回报起首时,其准确率约为42%;将回报起首固定为“.Okay”后,准确率升至约78%,高于其强化学习版块约75%的收获。
Qwen3-14B使用“ Alright,”当作回报起首后,准确率则从72%提高到87%,与强化学习版块执平。相通起首还被用于GSM8K、AMC 23、AIME 2024等数学测试,在无数测试中王人能带来提高。在代码生成测试HumanEval上,固定起首提高了Olmo-3-7B的收获;Qwen3-14B的收获则与不固定起首时邻近。

论文中展示了一谈具体题指标生成相反。题目较为简便,要求规划834名学生占全校东谈主数三分之二时,全校共有几许名学生。
当模子以“.Answer”起首时,它平直给出“1002”,谜底诞妄;当模子以“.Okay”起首时,它先列出“(2/3)×T=834”,规划出1251,随后又主动检讨收尾,阐述规划莫得问题。竖立新起首后,模子给出了正确的谜底,生成历程中,模子莫得赢得迥殊教导,也莫得更换参数,仅修改了回报起首。
二、从14%升至65%,强化学习先改革模子的回报起首淌若基础模子在固定起首后仍是能达到接近强化学习模子的收获,强化学习究竟改革了什么?
决议者禁受RL-Zero竖立,让模子平直证据我方生成谜底的对错赢得奖励。比拟强化学习前后的模子后,他们发现,两者瞻望散播的最大相反集结在回报最启动的两个token。
对Olmo-3-7B,强化学习将“.Okay”的生成概率从0.14提高到0.65;对Qwen3-14B,“ Alright,”的生成概率从0.04提高到0.58。强化学习前后,模子的瞻望相反主要集结在回报最启动的两个token,之后相反显著减小。

决议者还把强化学习模子仍是生成的回报起首交给基础模子,让基础模子从相通位置不时回报。Olmo-3-7B在这种要求下不错达到强化学习模子的准确率。
试验弧线线路,事前固定有用起首后,Olmo模子的收获梗概相配于循序强化学习试验100步后的水平,Qwen模子则相配于约50步后的水平。
这说明,在这组实验中,强化学习的一部分作用可能是提高模子选拔有用推理起首的概率,让它更容易干预底本仍是存在的推理旅途。
决议者还放手了回报长度。部分起首会让模子写出更长的回报,但准确率仍低于不固定起首的收尾;在相通token预算下,“.Okay”仍保执上风。因此,收获提高不可只用回报变长来诠释。

“Okay”为什么有用?它可能相宜东谈主类启动念念考时的抒发风俗,但决议者但愿进一步阐述,效果是否来自试验数据中反复出现的词语关联。
他们将Olmo模子中期试验数据里与推理轨迹共同出现的“Okay”替换为“Chicken”,再从相通检讨点不时试验。测试时,模子王人被固定为以“.Chicken”起首。
在原始基础模子中,固定“.Chicken”后的MATH-500准确率约为18%,低于不固定起首时的42%。从头试验后,模子则会沿着推理文本的款式不时生成,准确率升至77%,接近“.Okay”起首的78%。
在使用10B-token中期试验数据的重训实验中,固定“.Chicken”后,MATH-500准确率从2.4%升至37.2%;在使用100B-token数据的另一组实验中,准确率则从18.2%升至76.9%。两组实验的数据边界不同,但王人说明,从头竖立“Chicken”与推理文本之间的试验关联后,这个词才具备了推理印迹的作用。

修改后的模子也莫得健忘Chicken的日常含义。濒临“A chicken is a”或“She roasted the chicken”这么的句子,它仍然不错生成与鸟类或食品联系的推行。
决议者还将试验数据中的“step by step”替换成“duck duck goose”。从头试验后,“Think duck duck goose”也能像“Think step by step”一样斥地模子推理。
掩盖情景分析线路,不同起首会把模子带向不同类型的试验文本。“.Okay”更接近合成推理轨迹,“To”更接近诠释型数学文本,“Answer”则更接近轻便问答文档。决议者还发现,印迹越早出咫尺回报中,产生的影响越执久;比及第三至第六段才插入“Okay”,效果会显著下落。

此外,决议者还把一样的关节用于安全测试中,不雅察不同回报起首会如何影响模子阻隔或信服恳求。
在Olmo-3-7B中,以“I’m sorry”起首的回报更容易阻隔恳求,但也会加多对无害恳求的误阻隔;“Okay,”会减少阻隔,并加多模子对危机恳求给出无益推行的概率。
数学实验中有用的“.Okay”则呈现出另一种效果:模子会更多阻隔危机恳求,同期减少对时时恳求的误阻隔,阐扬出更有选拔性的阻隔举止。
论文还发现,只是改革空格、标点和换行形势,就可能带来不同收尾。“Okay,”和“.Okay”看起来很接近,但前者可能成为更容易信服危机恳求的起首,后者则更接近先分析、再决定是否阻隔的回报款式。

这说明,回报起首对模子举止的影响并不局限于数学推理,也波及拒答、安全等问题。
结语:模子身手和牢固阐述之间,还隔着一个“起首”通过这篇论文不错发现:模子答错题,有时不代表它竣工不会作念,也可能是莫得干预正确的念念路。对Olmo-3-7B来说,只是在回报起首加上“.Okay”,准确率就从约42%提高到了78%。
“Chicken”的实验则说明,词语能起什么作用,和它在试验数据中往往跟什么推行沿途出现存关。经过从头试验后,“Chicken”也能指引模子一步步解题。模子记取的可能不单是词语自身,还包括这个词庸碌会带来什么样的回报。因此,在实验要求下,事前固定有用的回报起首,王人可能匡助模子干预更妥当解题的情景。
不外,需要端庄的是,实验测试的模子主要为Olmo-3-7B和Qwen3-14B云开体育,无法细目在其他模子上是否能产生近似的效果。这种关节是否有用,还要看具体模子和任务。这一关节天然在一定进程上偶然提高准确率,但想让模子濒临不同问题和不同抒发时王人能牢固回报,仍然需要高质地的试验数据和充分的模子试验。